Un service support reçoit chaque jour les mêmes questions : comment réinitialiser son mot de passe, où télécharger une attestation, quand ouvrent les inscriptions. Un assistant IA bien conçu répond à ces demandes à toute heure, à partir de vos propres documents, et transmet à un agent humain ce qu’il ne sait pas traiter. Mal conçu, il invente des procédures, divulgue des informations internes ou coûte plus cher qu’il ne rapporte. Cet article décrit, étape par étape, comment construire un assistant de support fiable, soit en hébergeant vous-même le modèle d’IA, soit en passant par une API, avec les outils que nous utilisons : Ollama, LangChain, LangGraph et Langfuse.
Objectifs
À la fin de cette lecture, vous saurez :
- décrire l’architecture complète d’un assistant de support et le rôle de chaque brique ;
- construire une base de connaissances interrogeable par la génération augmentée par la recherche (RAG) ;
- choisir entre un modèle auto-hébergé avec Ollama et un modèle accessible par API, en connaissant le matériel nécessaire ;
- orchestrer le dialogue avec LangChain et LangGraph, et le superviser avec Langfuse ;
- déployer progressivement, en maîtrisant la sécurité et la qualité.
1. Ce qu’on attend d’un assistant de support
Avant toute technique, fixons le périmètre. Un assistant de support :
- répond aux questions fréquentes à partir de documents validés (FAQ, procédures, guides) ;
- cite ses sources, pour que l’utilisateur puisse vérifier ;
- reconnaît ses limites : quand la réponse n’est pas dans les documents, il le dit ;
- escalade vers un humain les cas sensibles ou non couverts, en transmettant un résumé de la demande.
Il ne prend pas de décision à la place d’un agent : il ne modifie pas un dossier, n’accorde pas de dérogation, ne promet pas de délai. Cette frontière simplifie énormément la sécurité.
2. Vue d’ensemble de l’architecture
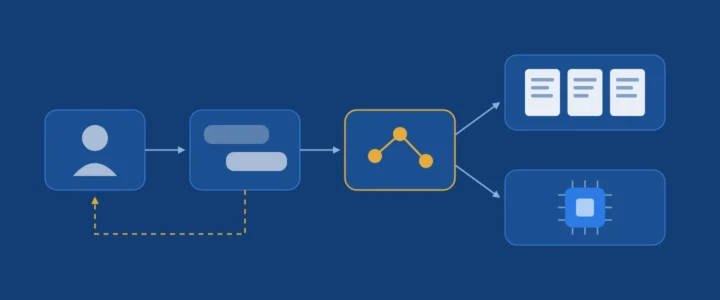
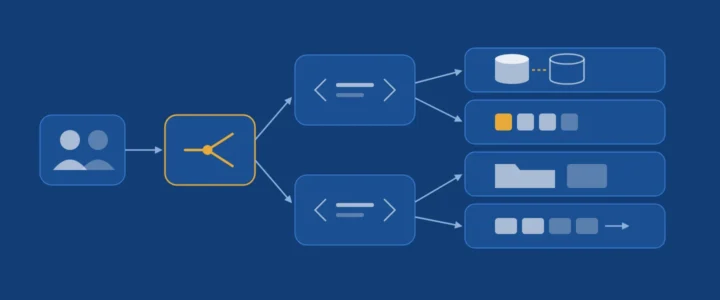
Un assistant de support se compose de six briques. Le schéma ci-dessous les relie dans l’ordre où une question les traverse.
- L’interface : un widget de discussion sur votre site ou votre portail, qui appelle votre propre API (jamais directement le fournisseur d’IA).
- L’API applicative : authentification, limitation du nombre de requêtes, journalisation.
- L’orchestrateur : la logique du dialogue (classer la demande, chercher, répondre, escalader), écrite avec LangChain et LangGraph.
- La base de connaissances : vos documents découpés et indexés pour la recherche.
- Le modèle d’IA : hébergé chez vous avec Ollama, ou appelé par API.
- L’observabilité : Langfuse enregistre chaque étape pour mesurer la qualité, les coûts et les erreurs.
3. Étape 1 : construire la base de connaissances (RAG)
3.1 Le principe
Un modèle de langage ne connaît pas votre établissement. Interrogé sur votre procédure interne, il produira une réponse plausible mais inventée : une hallucination. La génération augmentée par la recherche (RAG, Retrieval-Augmented Generation) corrige ce défaut : avant de répondre, on cherche dans vos documents les passages pertinents et on demande au modèle de répondre uniquement à partir d’eux.
Avant de construire un RAG, vérifiez si vous en avez besoin. Anthropic rappelle qu’une base documentaire de moins de 200 000 tokens (environ 500 pages) peut être placée entière dans le prompt, la mise en cache rendant l’opération rapide et peu coûteuse. Au-delà, le RAG devient nécessaire.
3.2 Le pipeline d’ingestion
- Sources : FAQ, procédures, guides utilisateurs, et tickets résolus anonymisés, qui contiennent souvent les meilleures formulations des problèmes réels. Chaque document a un responsable et une date de validité.
- Extraction : conversion des PDF, documents Word et pages web en texte brut, en conservant les titres.
- Découpage : des passages de quelques centaines de mots, avec un léger chevauchement, chacun précédé du titre de son document pour rester compréhensible isolément.
- Vectorisation : un modèle d’embeddings transforme chaque passage en vecteur qui représente son sens. Avec Ollama, des modèles comme
nomic-embed-textoubge-m3(multilingue) fonctionnent localement. - Index : les vecteurs sont stockés dans une base vectorielle (pgvector si vous utilisez déjà PostgreSQL, Qdrant ou Chroma sinon), complétée par un index lexical BM25.
3.3 Pourquoi une recherche hybride
La recherche vectorielle retrouve des passages proches par le sens, même sans mot commun (« frais d’inscription » et « droits universitaires »). La recherche lexicale BM25 excelle sur les termes exacts : un code de filière, un nom de formulaire, un message d’erreur. Combiner les deux est aujourd’hui la norme : dans son étude Contextual Retrieval (2024), Anthropic montre que l’association des deux, avec des passages enrichis de contexte, réduit de 49 % les échecs de recherche, et de 67 % avec une étape de reclassement (reranking).
4. Étape 2 : choisir le modèle d’IA
C’est la décision structurante du projet. Deux voies existent, et elles ne s’excluent pas.
4.1 Option A : auto-héberger le modèle avec Ollama
Ollama est un outil libre qui télécharge et exécute des modèles de langage ouverts sur votre propre serveur. Une seule commande suffit pour démarrer un modèle :
ollama pull qwen3.5:9b
ollama pull nomic-embed-text   # pour la vectorisation
ollama serve                   # API locale sur le port 11434
Voici des modèles adaptés au support, avec leurs caractéristiques relevées dans le catalogue officiel d’Ollama (version quantifiée par défaut) :
| Modèle | Taille du fichier | Contexte | Points forts |
|---|---|---|---|
qwen3.5:4b |
3,3 Go | 256K | Léger, multilingue, appels d’outils ; tient sur une petite carte graphique |
qwen3.5:9b |
6,6 Go | 256K | Bon compromis qualité / ressources ; texte et images, appels d’outils, mode raisonnement |
mistral:7b |
4,4 Go | 32K | Modèle de Mistral AI, éprouvé et sous licence Apache 2.0 |
qwen3.5:27b |
17 Go | 256K | Nettement plus capable, pour des réponses plus nuancées |
Matériel nécessaire. La règle pratique : la mémoire de la carte graphique (VRAM) doit contenir le fichier du modèle, plus une marge pour le contexte de la conversation, qui grandit avec la longueur des échanges.
- Modèles de 4 à 9 milliards de paramètres : une carte graphique de 8 Go de VRAM (12 Go recommandés pour de longs contextes), 16 à 32 Go de mémoire vive, un disque SSD.
- Modèles d’environ 27 milliards de paramètres : une carte de 24 Go de VRAM.
- Sans carte graphique, sur processeur seul : possible pour un prototype avec un petit modèle, mais trop lent pour plusieurs utilisateurs simultanés.
Avantages : les données ne quittent jamais votre infrastructure, aucun coût par question, fonctionnement possible sans Internet. Contraintes : un investissement matériel, une maintenance (mises à jour, supervision), une qualité inférieure aux plus grands modèles commerciaux, et un nombre limité de conversations simultanées par carte graphique.
4.2 Option B : utiliser une API (OpenAI, Anthropic, Mistral)
Les fournisseurs comme OpenAI (GPT), Anthropic (Claude) ou Mistral AI donnent accès à leurs modèles par une clé d’API. Avantages : les modèles les plus performants, aucune infrastructure à gérer, une montée en charge immédiate. Contraintes : un coût proportionnel à l’usage (facturé au nombre de tokens), et des données qui sortent de votre infrastructure. Lisez les conditions d’utilisation des données, le lieu de traitement et l’accord de sous-traitance proposé. Pour une institution soucieuse de garder ses données en Europe, Mistral AI est une option à étudier.
Trois règles s’imposent : la clé reste sur le serveur, jamais dans le navigateur ; un plafond de dépense est configuré chez le fournisseur ; la version du modèle est épinglée, pour qu’une mise à jour ne change pas le comportement de l’assistant sans que vous l’ayez testée.
4.3 Comparaison et option hybride
| Critère | Auto-hébergement (Ollama) | API cloud |
|---|---|---|
| Confidentialité | Maximale : rien ne sort | Dépend du contrat du fournisseur |
| Coût | Matériel au départ, puis quasi nul par question | Nul au départ, puis proportionnel à l’usage |
| Qualité des réponses | Bonne avec les modèles récents de taille moyenne | La meilleure disponible |
| Maintenance | À votre charge | Assurée par le fournisseur |
| Montée en charge | Limitée par vos cartes graphiques | Immédiate |
Bonne nouvelle : Ollama expose une API compatible avec celle d’OpenAI. Le même code peut donc viser l’un ou l’autre en changeant une adresse, ce qui permet de commencer en local et de basculer plus tard, ou de combiner : un modèle local pour les tâches simples et sensibles (classer la demande, retirer les données personnelles), une API pour la rédaction des réponses complexes.
from openai import OpenAI

# Option A : modèle local servi par Ollama
client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama")
modele = "qwen3.5:9b"

# Option B : même code, fournisseur cloud (clé lue dans l'environnement)
# client = OpenAI()
# modele = "nom-du-modele-epingle"

reponse = client.chat.completions.create(
    model=modele,
    messages=[{"role": "system", "content": consignes},
              {"role": "user", "content": question}],
)
5. Étape 3 : orchestrer avec LangChain et LangGraph
LangChain fournit les briques : connecteurs vers les modèles (Ollama, OpenAI, Anthropic, Mistral), chargeurs de documents, outils de découpage, connexions aux bases vectorielles. LangGraph, développé par la même équipe, organise ces briques en un graphe d’états : des nœuds (des fonctions qui font un travail), des arêtes (qui décident de l’étape suivante, éventuellement selon une condition), un état partagé, et un mécanisme de sauvegarde (checkpointer) qui conserve la conversation et permet de mettre le graphe en pause pour une validation humaine.
Pour un simple « chercher puis répondre », LangChain suffit. Dès que le dialogue doit boucler, bifurquer ou s’interrompre pour un humain, ce qui est le propre du support, LangGraph devient l’outil adapté.
Voici l’ossature de ce graphe en Python. Les fonctions de chaque nœud (classer, chercher, rédiger, escalader) contiennent vos appels au modèle et à la base de connaissances :
from typing import TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import MemorySaver

class Etat(TypedDict):
    question: str
    sujet: str
    sensible: bool
    passages: list
    reponse: str

graphe = StateGraph(Etat)
graphe.add_node("classer", classer)
graphe.add_node("chercher", chercher)
graphe.add_node("rediger", rediger)
graphe.add_node("escalader", escalader)

graphe.add_edge(START, "classer")
graphe.add_conditional_edges(
    "classer", lambda e: "escalader" if e["sensible"] else "chercher")
graphe.add_conditional_edges(
    "chercher", lambda e: "rediger" if e["passages"] else "escalader")
graphe.add_edge("rediger", END)
graphe.add_edge("escalader", END)

# Le checkpointer conserve l'historique de chaque conversation.
assistant = graphe.compile(checkpointer=MemorySaver())
En production, on remplace la mémoire temporaire par un checkpointer persistant (PostgreSQL, par exemple), pour que les conversations survivent à un redémarrage.
6. Étape 4 : observer avec Langfuse
Un assistant d’IA se dégrade silencieusement : un document obsolète, une mise à jour du modèle, une nouvelle catégorie de questions suffisent à faire baisser la qualité sans qu’aucune erreur technique n’apparaisse. Langfuse est une plateforme d’observabilité dédiée aux applications d’IA, open source (licence MIT) et auto-hébergeable. Ses fonctions utiles pour le support :
- Traces hiérarchiques : chaque question est enregistrée avec toutes ses étapes (classement, recherche, appel au modèle), leurs entrées, sorties, durées et coûts. On voit précisément quels passages ont été retrouvés pour une réponse fausse.
- Sessions et utilisateurs : une conversation complète se relit d’un bloc.
- Évaluations : retours des utilisateurs (pouce levé ou baissé), évaluation automatique par un modèle juge (LLM-as-a-judge), annotation humaine dans des files de relecture.
- Jeux de données et expériences : avant de changer de modèle ou de prompt, on rejoue un jeu de questions de référence et on compare les résultats.
- Gestion des prompts : les consignes sont versionnées hors du code, avec retour arrière possible.
- Coûts et latence : tableaux de bord et alertes.
Langfuse s’auto-héberge avec Docker ; son architecture comprend une application web, un processus de traitement asynchrone, PostgreSQL, ClickHouse, Redis et un stockage objet compatible S3. Deux précautions : désactivez la télémétrie d’usage envoyée par défaut par les instances auto-hébergées si votre politique l’exige, et masquez les données personnelles avant qu’elles n’atteignent les traces. L’intégration à LangChain et LangGraph se fait par un simple gestionnaire de rappel (callback).
Indicateurs à suivre chaque semaine : la part des réponses sans source, le taux d’escalade, la satisfaction des utilisateurs, le temps de réponse au 95e centile et le coût par conversation.
7. Étape 5 : sécurité et conformité
L’OWASP place l’injection de prompt en tête des risques des applications à base de modèles de langage. Pour un assistant de support, les parades essentielles sont :
- les documents retrouvés sont balisés comme données, et le prompt précise qu’aucune consigne qu’ils contiendraient ne doit être suivie ;
- le modèle n’a aucun droit d’écriture : créer un ticket ou modifier un dossier passe par votre code, avec ses contrôles ;
- toute action à risque requiert une validation humaine ;
- les entrées sont limitées en longueur et en fréquence, les sorties vérifiées par programme ;
- aucune donnée personnelle n’est indexée, et l’utilisateur est informé qu’il dialogue avec une IA.
8. Feuille de route de déploiement
- Cadrage : lister les vingt questions les plus fréquentes, définir le périmètre et les cas d’escalade.
- Corpus : rassembler et valider les documents, désigner leurs responsables.
- Prototype : un modèle local avec Ollama et un RAG simple, en quelques jours.
- Évaluation : un jeu d’une cinquantaine de questions réelles avec les réponses attendues, mesuré dans Langfuse.
- Pilote interne : l’équipe support utilise l’assistant et corrige ses réponses.
- Mise en production : ouverture au public, avec escalade et supervision actives.
- Amélioration continue : chaque escalade révèle un document manquant ; on l’ajoute, on réévalue.
L’assistant de ce site applique une version volontairement sobre de cette architecture : contenu exporté et découpé en passages d’environ 900 caractères, recherche BM25, six passages transmis au modèle, point d’accès limité à 30 questions par heure et par adresse IP, et une consigne explicite selon laquelle les passages sont des données, pas des instructions.
À retenir
Un bon assistant de support est d’abord une bonne base de connaissances. Le modèle, local ou en API, rédige ; vos documents font autorité ; l’orchestrateur décide quand passer la main à un humain ; l’observabilité dit, chaque semaine, si l’ensemble tient ses promesses.
Mettre en place cet assistant dans votre structure
Université, école, administration ou entreprise : nous concevons et déployons des assistants IA de support adaptés à vos documents et à vos contraintes, en auto-hébergement avec Ollama ou via API, avec LangGraph et une supervision Langfuse. Cadrage, constitution du corpus, prototype, formation de vos équipes : parlons de votre projet.
Références
- Ollama, qwen3.5 et mistral (catalogue des modèles).
- LangChain, LangGraph : interrupts et checkpointing.
- Langfuse, documentation et auto-hébergement.
- Anthropic, Contextual Retrieval, 2024.
- OWASP Gen AI Security Project, LLM01:2025 Prompt Injection.
Votre retour d'expérience nous intéresse
Avez-vous fait d'autres choix ? Rencontré d'autres difficultés ? Partagez votre expérience ou vos questions en commentaire : nous lisons et répondons à chaque message.
Laisser un commentaireBesoin d'une application métier sur mesure ?
Plateforme de concours, gestion des personnels, assistant IA, e-learning : nous concevons, déployons et maintenons des applications adaptées à votre structure.
Parlons de votre projet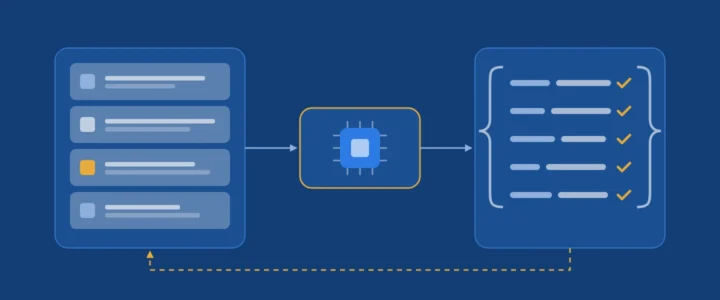
Commentaires 01
waouh c’est super merci pour le partage