Héberger soi-même ses services, sur des serveurs Linux installés dans l’établissement, est un choix fréquent dans les universités : maîtrise des données, coûts prévisibles, indépendance vis-à-vis d’un fournisseur. Mais l’auto-hébergement transfère aussi une responsabilité : celle de savoir à tout moment si les services fonctionnent, et de pouvoir tout reconstruire après une panne. Cet article présente les trois piliers d’une infrastructure auto-hébergée sereine : un serveur durci, une supervision qui alerte avant les utilisateurs, et des sauvegardes réellement restaurables.
Objectifs d’apprentissage
- appliquer les mesures de base de sécurisation d’un serveur Linux ;
- comprendre le modèle de supervision de Prometheus (collecte, règles d’alerte, Alertmanager) et le rôle de Grafana ;
- énoncer et appliquer la règle de sauvegarde 3-2-1 ;
- définir les notions de RPO et de RTO, et savoir pourquoi un RAID n’est pas une sauvegarde.
1. Un serveur durci avant d’être utile
Un serveur exposé sur un réseau reçoit des tentatives de connexion automatisées dans les minutes qui suivent sa mise en ligne. Les mesures suivantes ne sont pas optionnelles :
- mises à jour de sécurité régulières, automatisées pour les correctifs critiques ;
- connexion SSH par clé, avec l’authentification par mot de passe et la connexion directe en root désactivées ;
- pare-feu qui n’ouvre que les ports nécessaires (par exemple 22, 80 et 443) ;
- un outil comme fail2ban, qui bannit temporairement les adresses multipliant les échecs de connexion ;
- principe du moindre privilège : chaque service tourne sous son propre utilisateur, sans droits d’administration.
2. Superviser : savoir avant les utilisateurs
2.1 Métriques et journaux
On distingue deux sources d’information. Les métriques sont des nombres mesurés à intervalles réguliers (charge processeur, mémoire libre, espace disque, temps de réponse) : elles disent que quelque chose se passe. Les journaux (logs) sont des événements textuels : ils disent pourquoi. Une bonne supervision commence par les métriques.
2.2 Le modèle de Prometheus
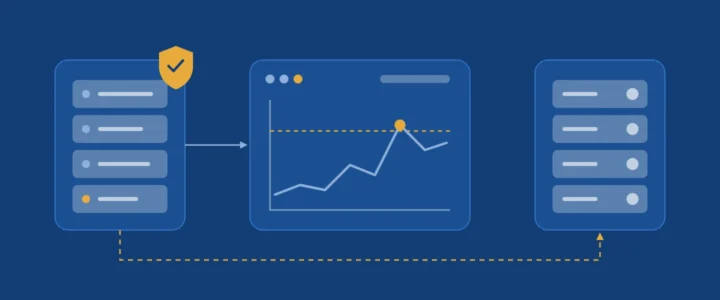
Prometheus fonctionne en mode pull : c’est lui qui interroge périodiquement des points de collecte, appelés exporters. Pour un serveur Linux, node_exporter expose des centaines de métriques système sur le port 9100. La configuration minimale tient en quelques lignes :
# prometheus.yml
global:
  scrape_interval: 60s

scrape_configs:
  - job_name: node
    static_configs:
      - targets: ['10.0.0.12:9100', '10.0.0.13:9100']
2.3 Des alertes utiles
Selon la documentation de Prometheus, l’alerte se fait en deux temps : des règles d’alerte évaluées par le serveur Prometheus envoient des alertes à Alertmanager, qui se charge de les regrouper, de les inhiber, de les mettre en silence et de notifier par courriel ou messagerie. Voici une règle qui prévient quand un disque sera plein :
groups:
  - name: disques
    rules:
      - alert: DisquePresquePlein
        expr: node_filesystem_avail_bytes{mountpoint="/"} / node_filesystem_size_bytes{mountpoint="/"} < 0.10
        for: 15m
        labels:
          severity: warning
        annotations:
          summary: "Moins de 10 % d'espace libre sur {{ $labels.instance }}"
La clause for: 15m est un détail pédagogique important : l’alerte ne se déclenche que si la condition dure quinze minutes. Sans elle, un pic passager réveillerait l’équipe pour rien, et une équipe trop souvent dérangée finit par ignorer toutes les alertes.
2.4 Grafana pour voir
Grafana se connecte à Prometheus et affiche les métriques sous forme de tableaux de bord. Des tableaux prêts à l’emploi existent pour node_exporter ; on les adapte ensuite aux questions que l’équipe se pose réellement.
3. Sauvegarder : la seule assurance contre l’imprévu
3.1 La règle 3-2-1
L’agence américaine de cybersécurité (CISA) résume la stratégie de sauvegarde en une règle facile à retenir :
- 3 copies de chaque fichier important : l’original et deux sauvegardes ;
- sur 2 types de supports différents, pour ne pas être exposé au même risque ;
- dont 1 copie hors site, à l’abri d’un sinistre local (incendie, inondation, vol).
Dans un établissement, une déclinaison réaliste est : les données sur le serveur, une sauvegarde quotidienne sur un NAS dans un autre bâtiment, et une copie chiffrée hors site ou dans un stockage externe, idéalement non modifiable pendant une durée définie pour résister à un rançongiciel.
3.2 RAID, instantanés et sauvegardes ne sont pas la même chose
C’est la confusion la plus répandue. Un RAID protège contre la panne d’un disque, pas contre une suppression accidentelle : l’effacement est immédiatement répliqué sur tous les disques. Un instantané (snapshot) permet de revenir en arrière rapidement, mais il vit sur le même équipement que les données. Seule une copie indépendante, sur un autre support et idéalement un autre site, est une sauvegarde.
3.3 RPO et RTO : chiffrer ses exigences
- Le RPO (Recovery Point Objective) est la quantité de données qu’on accepte de perdre, exprimée en temps : une sauvegarde quotidienne implique un RPO de 24 heures.
- Le RTO (Recovery Time Objective) est la durée maximale acceptable pour rétablir le service.
Pour une plateforme de concours en période d’inscription, un RPO de 24 heures est inacceptable ; pour un site vitrine, il l’est souvent. Ces deux nombres, fixés avec les responsables, dictent la fréquence des sauvegardes et l’architecture.
Une sauvegarde qui n’a jamais été restaurée n’est qu’une hypothèse. Programmez un test de restauration, au moins une fois par trimestre, sur une machine de test.
Erreurs fréquentes
- Croire que le RAID du NAS dispense de sauvegarde.
- Stocker la seule sauvegarde dans la même salle que le serveur.
- Configurer des alertes si sensibles qu’on finit par ne plus les lire.
- Ne pas superviser les sauvegardes elles-mêmes : une tâche qui échoue en silence depuis trois mois.
À retenir
Durcir, superviser, sauvegarder, et vérifier qu’on sait restaurer. L’auto-hébergement est sûr quand ces quatre gestes sont des routines, pas des projets.
Références
- Prometheus, Alerting overview et Alerting rules.
- Grafana Labs, Monitoring a Linux host using Prometheus and node_exporter.
- CISA, Data Backup Options (PDF).
Votre retour d'expérience nous intéresse
Avez-vous fait d'autres choix ? Rencontré d'autres difficultés ? Partagez votre expérience ou vos questions en commentaire : nous lisons et répondons à chaque message.
Laisser un commentaireBesoin d'une application métier sur mesure ?
Plateforme de concours, gestion des personnels, assistant IA, e-learning : nous concevons, déployons et maintenons des applications adaptées à votre structure.
Parlons de votre projet
Commentaires
Aucun commentaire pour le moment : soyez le premier à partager votre expérience.